El nuevo opt-out de entrenamiento de IA en robots.txt: qué bloquea y qué no
__usage_ai-training permite pedir en robots.txt que Google, OpenAI, Microsoft y Anthropic no entrenen IA con tu web. Qué bloquea, qué no y cómo auditarlo.
Abrís robots.txt para frenar el entrenamiento de IA. Antes de guardar, revisá qué visibilidad querés conservar.
El nuevo token User-Agent: __usage_ai-training permite expresar en robots.txt una preferencia sobre entrenamiento de IA. Anthropic, Google, OpenAI y Microsoft lo respaldaron el 30 de octubre de 2026; no es un bloqueo de rastreo ni una exclusión de Search. Al 31 de octubre, ninguna de las cuatro empresas dice que esté activo para sus crawlers.
Antes de bloquear bots, separá entrenamiento, indexación y consultas para respuestas.
| Empresa | Qué comprometió | Cuándo | Fuente |
|---|---|---|---|
| Anthropic | Ya empezó la implementación; extenderla a sus servicios llevará tiempo | Sin fecha de activación | Correo IETF, 30 de octubre de 2026 |
| Interpretará el opt-out como Google-Extended disallow si Google-Extended no está especificado | 2027 (blog); principios de 2027 (documentación de crawlers) | Search Central, 30 de octubre de 2026 | |
| Microsoft | Respetará la preferencia al rastrear; suma entrenamiento y grounding por página | 1 de febrero de 2027; migrar NoArchive/NoCache antes del 1 de marzo de 2027 | Blog de Bing, octubre de 2026 |
| OpenAI | Respetará la señal compartida | “in the coming months”, sin fecha | OpenAI, 30 de octubre de 2026 |
Qué significa bloquear entrenamiento de IA en robots.txt
El borrador individual presentado ante IETF propone usar grupos comunes de robots.txt. Agrega un token de política en la línea User-Agent, sin directivas ni gramática nuevas. Este es el ejemplo del documento:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Expresa una preferencia contraria al entrenamiento para todas las rutas salvo /press-kit/. Para esa ruta expresa una preferencia favorable. Se aplican las reglas de coincidencia de rutas y precedencia de la coincidencia más larga de RFC 9309.
El grupo comodín User-Agent: * no debe interpretarse como una coincidencia con este token. Sin un grupo __usage_ai-training, el mecanismo no expresa ninguna preferencia.
La coincidencia del token es exacta, salvo mayúsculas y minúsculas. Podés combinar varios tokens mediante líneas User-Agent consecutivas, incluso tokens de política y de producto.
El borrador define entrenamiento como usar un recurso para modificar los parámetros aprendidos de un modelo generativo. Excluye modelos destinados exclusivamente a tareas no generativas; clasificación, ranking y scoring quedan fuera de su definición de modelo generativo. No abarca cualquier uso que lleve la etiqueta IA.
Es una preferencia de uso del contenido, no una orden sobre rastreo. Los acuerdos privados pueden prevalecer y los tokens propios de cada proveedor conservan su significado.
Además, sigue siendo la versión 00 de una presentación individual. Su intención es Standards Track, pero no tiene respaldo de IETF ni estatus formal. Vence el 3 de mayo de 2027.
Quiénes se comprometieron y para cuándo
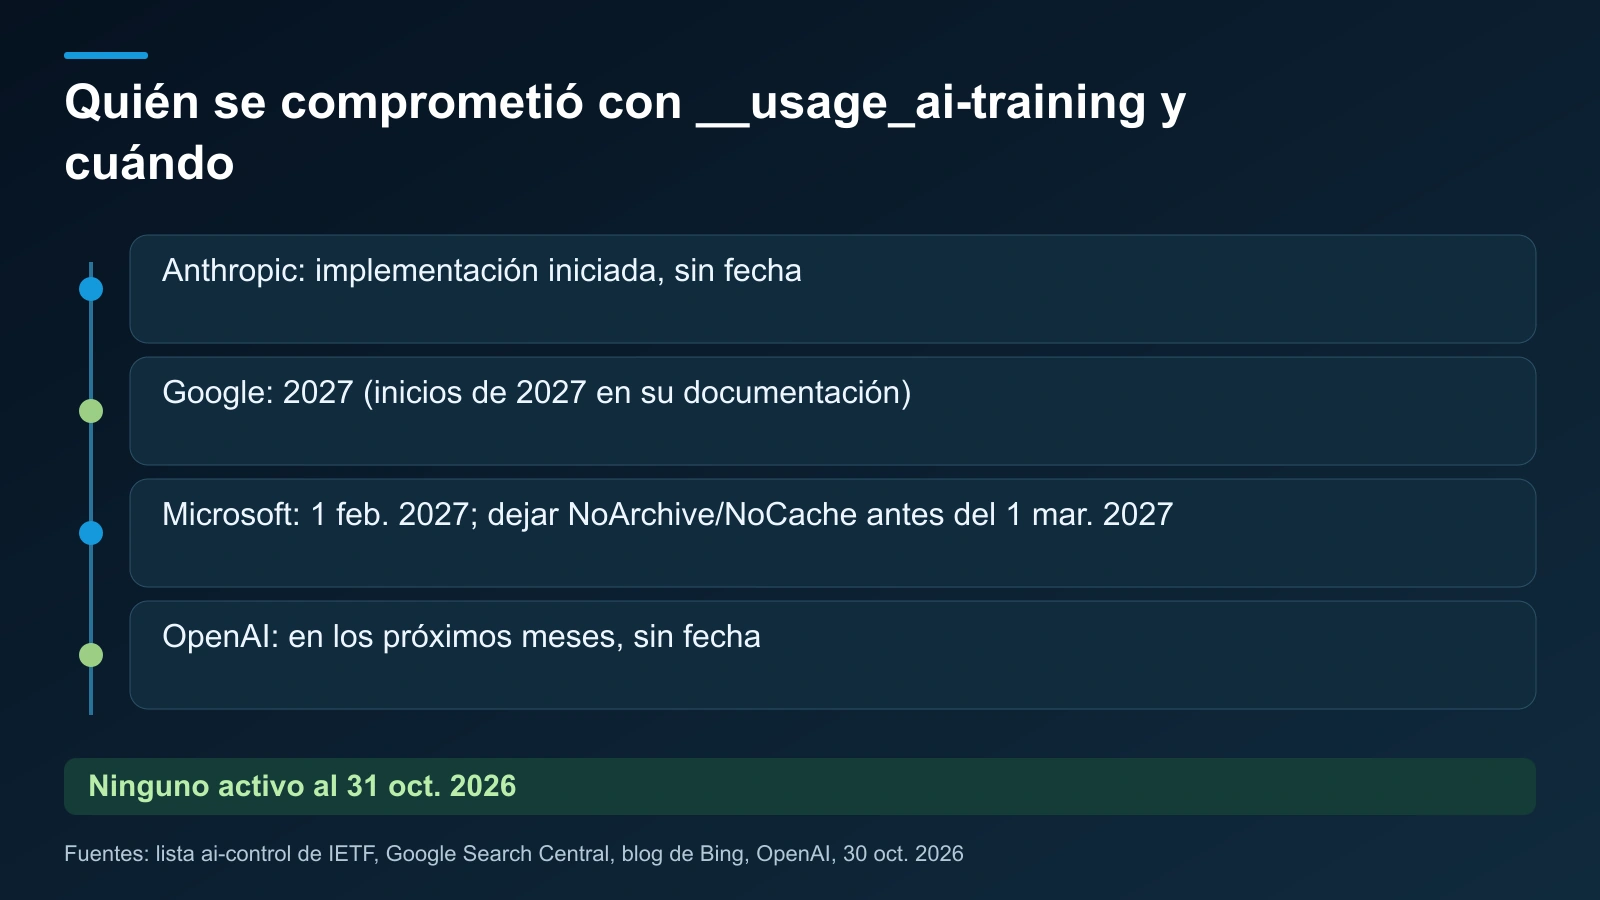
Google publicó: “We aim to support this new control along with other AI providers in 2027.” Su documentación de crawlers habla de principios de 2027. La interpretación como Google-Extended disallow depende de que no hayas especificado Google-Extended explícitamente.
OpenAI dice: “We aim to implement the signal in the coming months, and will share another update”. Su anuncio mantiene los controles actuales de robots.txt.
Microsoft sí da un día: empezará a respetar las preferencias al rastrear desde el 1 de febrero de 2027. En su publicación de Bing advierte: “Neither choice guarantees inclusion, traffic, or payment.”
Según The Verge, Andy Stone, de Meta, expresó apoyo a una señal común. No dijo que Meta vaya a respetarla.
Entrenamiento, Search y respuestas de IA: tres decisiones
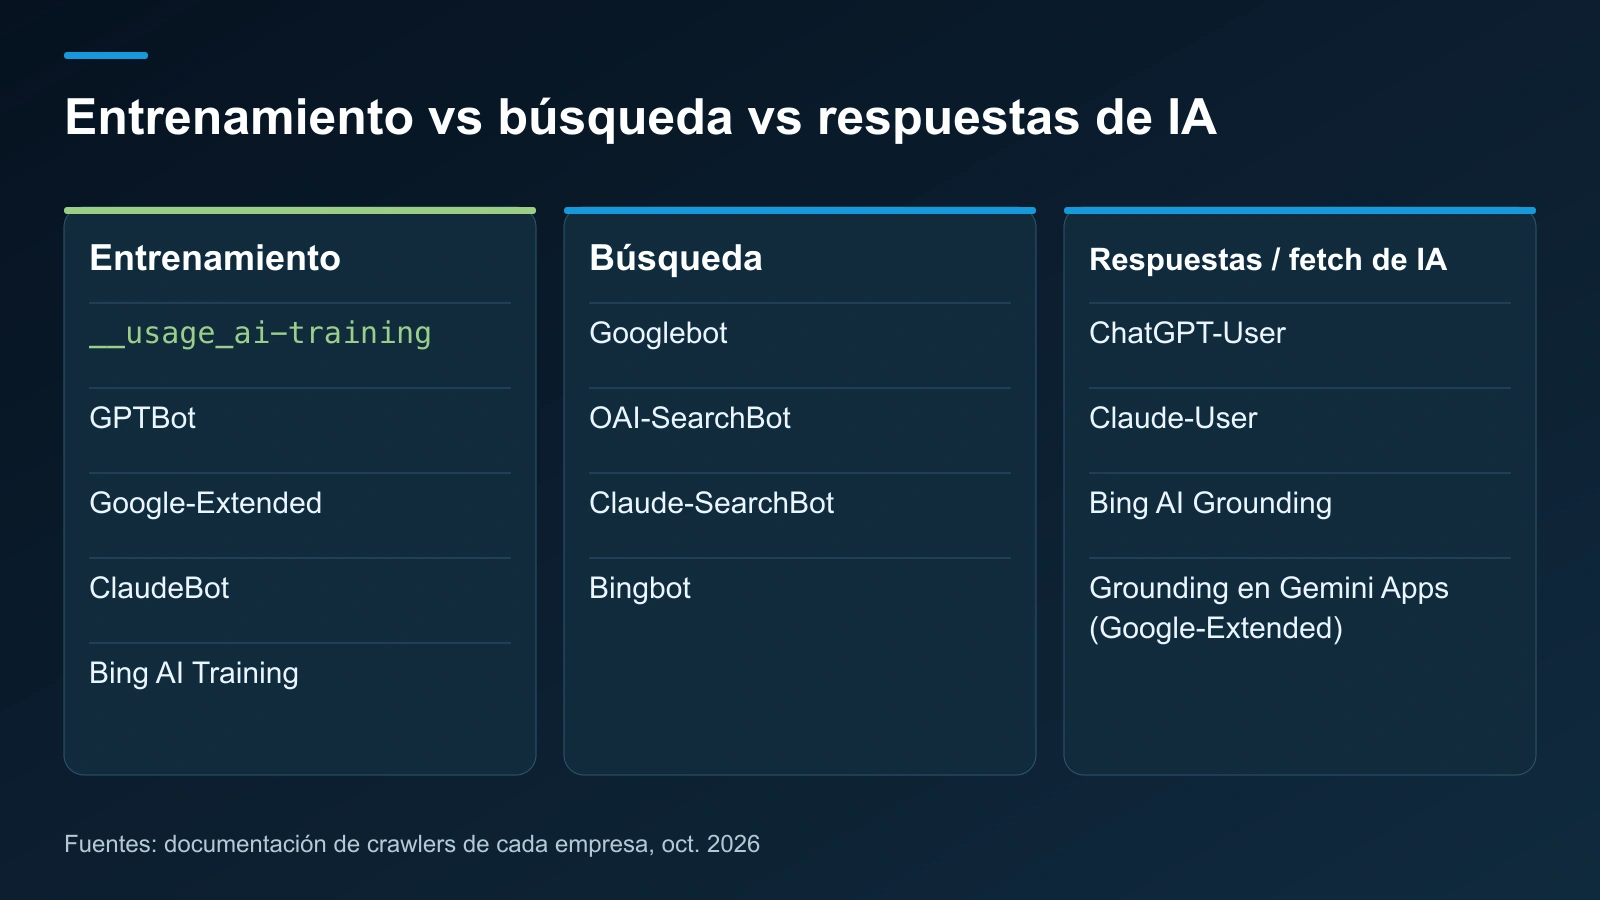
| Control | Qué regula | Qué no regula |
|---|---|---|
| Token compartido | Preferencia futura de entrenamiento por ruta | Bloqueo de rastreo o exclusión general de Search |
| GPTBot | Preferencia sobre recolección para entrenamiento de OpenAI | Configuración de OAI-SearchBot o consultas de usuarios |
| OAI-SearchBot | Visibilidad en búsquedas de OpenAI | Preferencia de entrenamiento de GPTBot |
| ChatGPT-User | Consultas iniciadas por usuarios | No reemplaza controles de entrenamiento |
| Google-Extended | Entrenamiento de Google y elegibilidad para grounding en Gemini Apps | Inclusión o ranking en Google Search |
| Googlebot | Google Search, incluidos AI Overviews y AI Mode | La preferencia separada Google-Extended |
| ClaudeBot | Recolección que puede contribuir al entrenamiento | Búsquedas y consultas de usuarios de Claude |
| Claude-SearchBot | Mejora de resultados de búsqueda de Claude | Preferencia de entrenamiento de ClaudeBot |
| Claude-User | Consultas para responder pedidos de usuarios | No es un control exclusivo de entrenamiento |
| Bing AI Training | Entrenamiento, con prioridad de la configuración por página | Grounding o elegibilidad en Bing Search |
| Bing AI Grounding | Preferencia independiente de grounding por página | Permiso de entrenamiento o elegibilidad en Search |
La documentación de bots de OpenAI permite configurar sus agentes de forma independiente. Podés bloquear GPTBot y permitir OAI-SearchBot. ChatGPT-User atiende consultas iniciadas por usuarios.
La ayuda de crawlers de Anthropic también separa ClaudeBot, Claude-SearchBot y Claude-User. Bloquear los dos últimos puede reducir visibilidad en búsquedas o consultas dirigidas por usuarios.
Google requiere una revisión especial. Si Google-Extended no está especificado, planea interpretar el opt-out compartido como un disallow para ese control. Permitirlo explícitamente conserva la elegibilidad para respuestas y clics mediante grounding en Gemini Apps. Elegibilidad no significa aparición asegurada.
Google-Extended no tiene un user agent HTTP propio: es un token de control. No afecta la inclusión ni es una señal de ranking en Google Search. Para AI Overviews y AI Mode, consultá el control del lado de Search. Es otra decisión, con otro alcance.
Bing mantiene entrenamiento y grounding independientes; ambos parten de Allow. La preferencia de entrenamiento por página prevalece sobre robots.txt. Para grounding ofrece Allow, Disallow y DisallowExtended. La última limita el uso a experiencias operadas por Microsoft, como Copilot, y excluye servicios vendidos a terceros, como Web IQ y Foundry API.
Esto no modifica la elegibilidad en Bing Search. Microsoft sí advierte que bloquear grounding reduce la visibilidad de marca en experiencias de IA. No lo uses como sustituto del control de entrenamiento.
Migrá NoArchive/NoCache antes del 1 de marzo de 2027: después dejan de interpretarse como preferencias de entrenamiento o grounding. Para sitios que los usan, Bing Webmaster Tools ofrecerá una preferencia temporal de grounding desde el 15 de diciembre de 2026. Durará hasta el nuevo rastreo o el 30 de septiembre de 2027.
Expert Insight Yo separaría el permiso de entrenamiento de la visibilidad en respuestas de IA. El error que más espero ver es bloquear agentes de búsqueda y consultas junto con los de entrenamiento. Dejá por escrito el motivo de cada regla antes de publicarla.
Errores comunes en robots.txt y cómo corregirlos
Esta lista es mi lectura práctica de la documentación. No representa una medición de errores en sitios.
- Bloquear todos los agentes juntos. Corregilo separando GPTBot y ClaudeBot de OAI-SearchBot, Claude-SearchBot, ChatGPT-User y Claude-User. Revisá qué uso querés restringir.
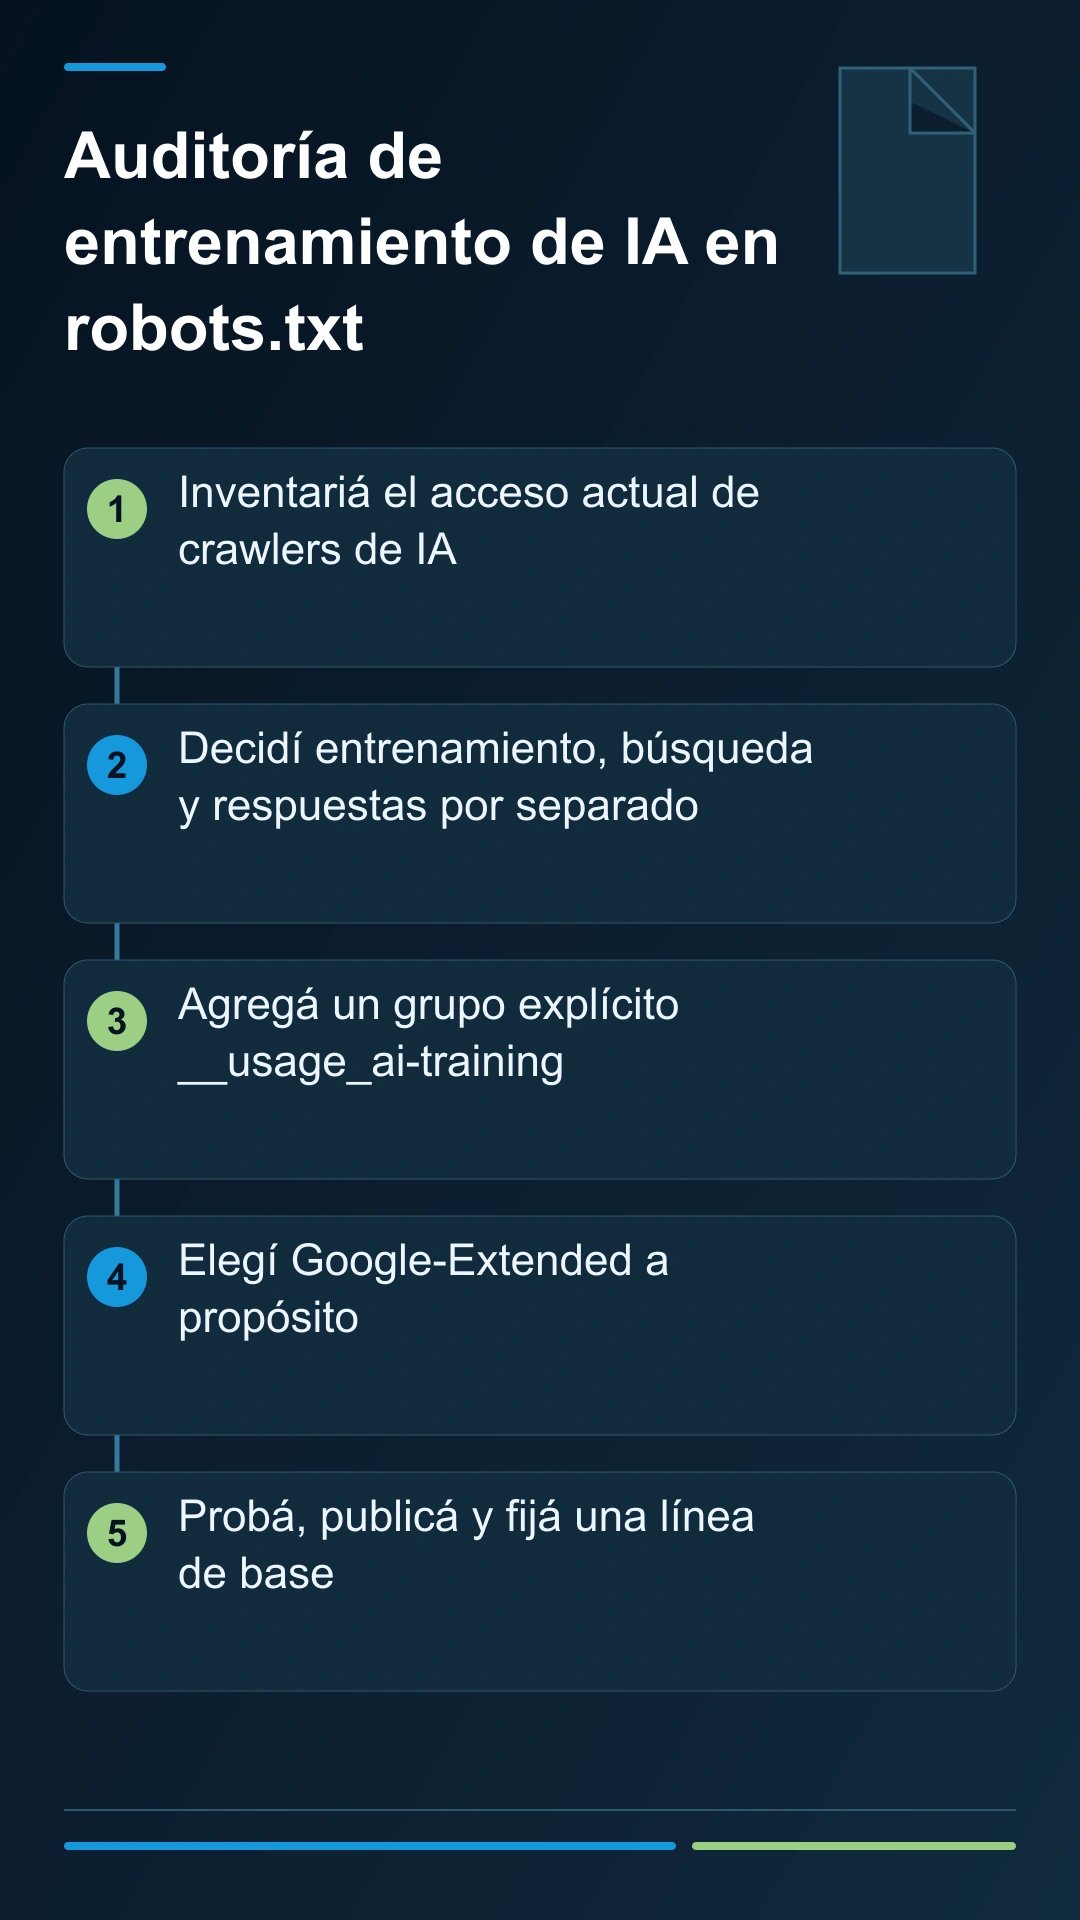
- Confiar en el comodín. Agregá un grupo explícito para
__usage_ai-training.User-Agent: *no expresa esta preferencia. - Dejar Google-Extended sin decidir. Definí si aceptás su alcance de entrenamiento y grounding en Gemini Apps. Documentá el costo de esa elección.
- Esperar que desaparezcan solicitudes o entrenamiento anterior. Separá uso futuro de rastreo. Ninguna fuente dice que la señal sea retroactiva.
- Bloquear grounding de Bing para frenar entrenamiento. Configurá la preferencia de entrenamiento independiente. Restringí grounding solamente si aceptás su efecto sobre visibilidad.
- Seguir únicamente con NoArchive/NoCache. Migrá las preferencias de Bing antes del 1 de marzo de 2027 y revisá la configuración por página.
- Usar robots.txt como seguridad. No dependas del archivo para impedir acceso. Los scrapers que no cumplen pueden ignorarlo.
Las guías sobre crawlers de IA y llms.txt te dan contexto para revisar el conjunto sin mezclar los controles.
Checklist de auditoría: decidí, editá y verificá
# Ejemplo: preferencia compartida y controles actuales de proveedores.
User-Agent: __usage_ai-training
Disallow: /

User-Agent: GPTBot
Disallow: /

User-Agent: ClaudeBot
Disallow: /

# Elección explícita. Disallow deja el entrenamiento apagado en Google.
# Allow conservaría la elegibilidad en Gemini Apps, pero también permite entrenar.
User-Agent: Google-Extended
Disallow: /

User-Agent: OAI-SearchBot
Allow: /

User-Agent: Claude-SearchBot
Allow: /

User-Agent: ChatGPT-User
Allow: /

User-Agent: Claude-User
Allow: /
El ejemplo bloquea Google-Extended de forma explícita, así la decisión sobre Google queda a la vista. El costo es la elegibilidad para grounding en Gemini Apps; si esas respuestas te importan más que la preferencia de entrenamiento en Google, cambiá ese grupo a Allow y dejá anotado por qué. Con este token, Google no ofrece "entrenamiento apagado y respuestas encendidas".
Revisá aparte el acceso existente de Googlebot y Bingbot. Las preferencias de grounding de Bing por página también necesitan revisión propia; este fragmento no las configura.
Cómo medir en GSC y referrals de IA
Tomá un baseline ahora: ninguna de las cuatro empresas anunció la señal como activa. El token por sí solo no debería cambiar rankings de Google Search; Google-Extended no es una señal de ranking. Una variación posterior no demostraría que esta edición la causó.
El reporte de rendimiento de IA generativa en Search Console permite revisar impresiones por página, país, fecha y dispositivo. No incluye clics. Conservá ese límite cuando compares exposición con sesiones en analytics.
Segmentá referrals de chatgpt.com, perplexity.ai, gemini.google.com, copilot.microsoft.com y claude.ai. Compará cuatro semanas antes y después del cambio. La comparación no aísla el efecto de la preferencia.
En logs, compará solicitudes de GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, Googlebot y Bingbot. El token no modifica el rastreo por sí mismo. Revisá rendimiento de IA o citas en Bing Webmaster Tools donde estén disponibles.
Anotá el anuncio del 30 de octubre, tu fecha de publicación, el 1 de febrero de 2027 y el objetivo de Google para principios de 2027. Separá fechas anunciadas de implementación verificada. Solicitudes, exposición y referrals responden preguntas distintas.
Preguntas frecuentes
¿__usage_ai-training bloquea crawlers de IA?
No. Expresa una preferencia sobre uso para entrenamiento. Conservá controles de rastreo específicos cuando respondan a tu política.
¿Afecta Google Search o AI Overviews?
No es una exclusión de Search. Google-Extended no afecta inclusión ni ranking; los controles de las funciones de búsqueda con IA son independientes.
¿Lo cubre User-Agent: *?
No. El borrador excluye explícitamente la coincidencia con el comodín. Sin el grupo propio, este mecanismo no expresa preferencia.
¿Todavía necesito reglas para GPTBot y Google-Extended?
Los controles existentes siguen vigentes. Conservá las reglas deliberadas mientras llega el soporte compartido y decidí explícitamente el alcance de Google-Extended.
¿Cuándo empieza a funcionar?
Al 31 de octubre de 2026, ninguna empresa dice que esté activo. Microsoft indica el 1 de febrero de 2027; Google, 2027 y principios de 2027 en su documentación. OpenAI dice “in the coming months”; Anthropic no da fecha.
¿Elimina contenido que ya se usó para entrenar?
Ninguna fuente dice que aplique retroactivamente. Publicar el grupo no demuestra eliminación de material usado antes.
Una preferencia publicada no prueba implementación ni cumplimiento.
Growing Search puede ayudarte a revisar estas decisiones junto con tu visibilidad en una auditoría SEO.
Sobre el autor