Herramientas de visibilidad en IA y el límite de los prompt trackers
Cómo evaluar trackers de prompts, registrar su muestra y combinar simulaciones con datos de primera parte sin presentar una puntuación como ranking estable.
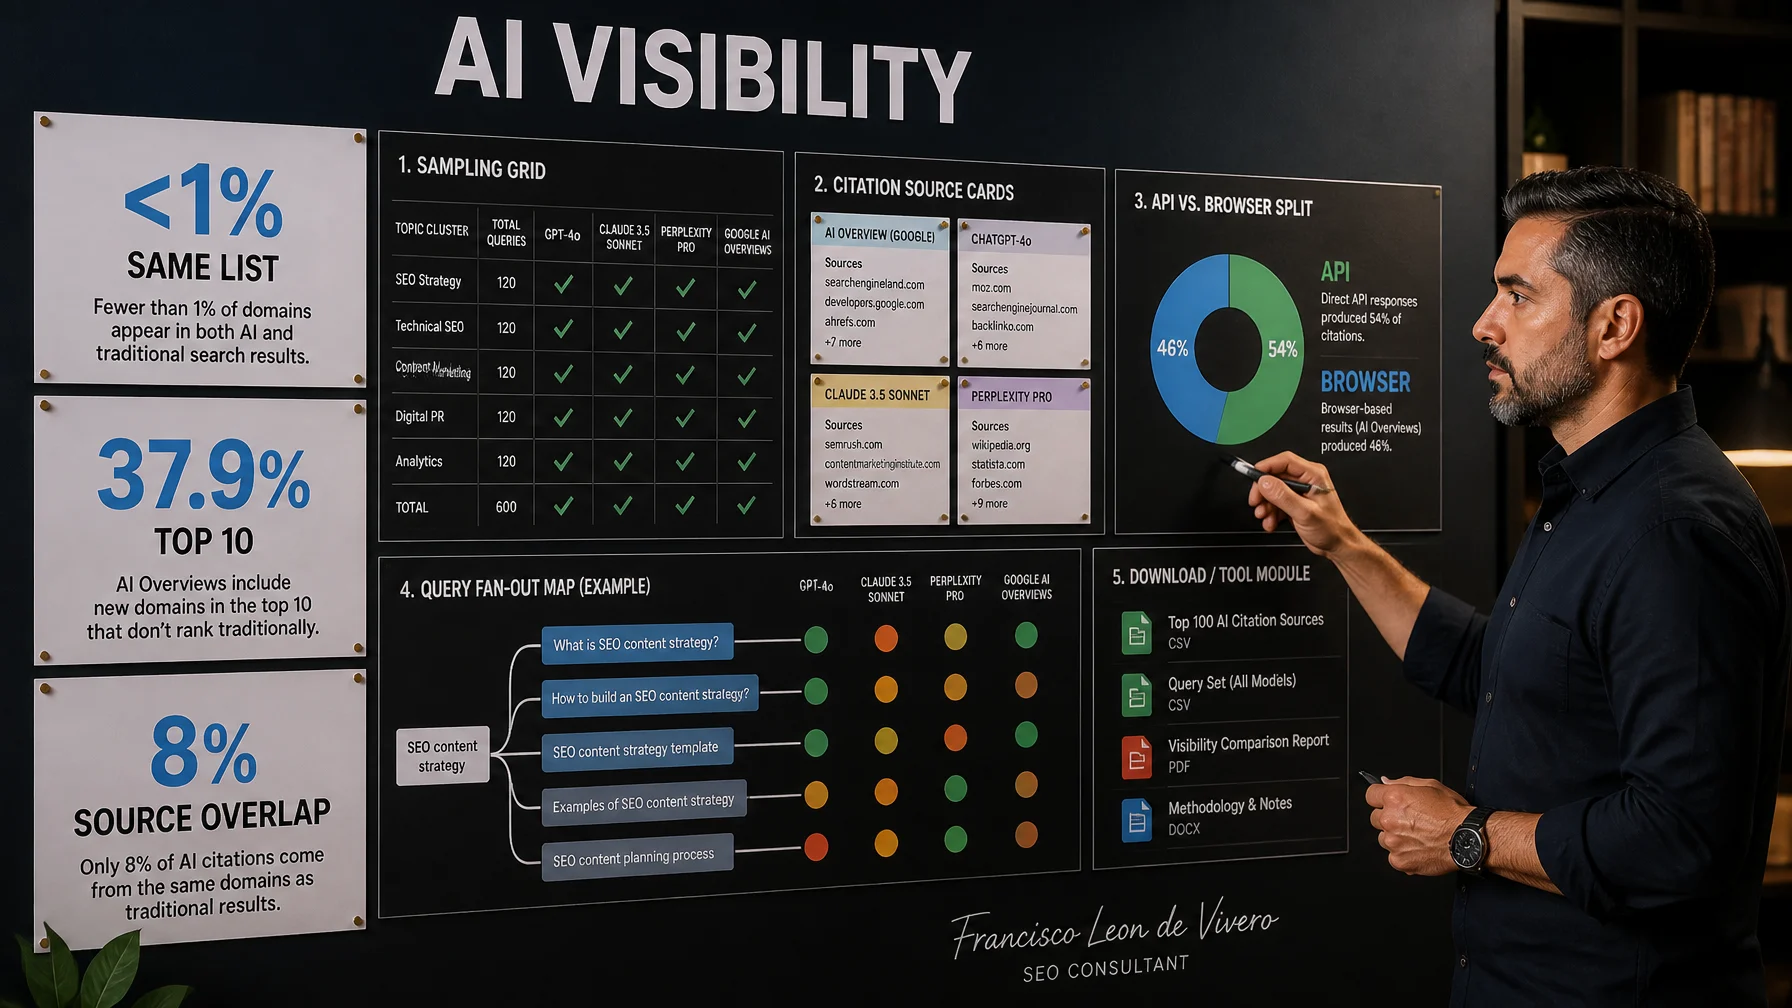
En breve: Un prompt tracker mide respuestas obtenidas bajo su propio conjunto de preguntas, cuentas, ubicaciones y proveedores. Esa muestra puede revelar temas ausentes o fuentes recurrentes. No reproduce todas las sesiones de los compradores ni ofrece una posición estable comparable con el ranking orgánico. El informe debe mostrar el método, las repeticiones y la variación.
La evidencia de primera parte merece prioridad cuando existe. Los datos de sitios verificados, logs y conversiones describen exposición o visitas observadas. Una simulación externa sirve para formular hipótesis.
Análisis de medición en cinco minutos
Muestras direccionales frente a rankings
El video revisa variación, diferencias entre API e interfaz y un proceso reproducible para comparar respuestas.
La medición producida por un tracker
El proveedor selecciona prompts, ejecuta respuestas y clasifica menciones o citas. El porcentaje final depende de decisiones previas al cálculo. Cambiar idioma, país, redacción, modelo, fecha o número de repeticiones puede cambiar el resultado aunque el sitio permanezca igual.
Las bases comerciales también difieren. Ahrefs describe Brand Radar como una base de prompts respaldados por demanda de búsqueda. Semrush documenta una base propia y actualizaciones continuas. SISTRIX explica los modelos e idiomas de su herramienta. Comparar puntuaciones entre proveedores sin alinear el universo de preguntas mezcla metodologías.
Variación entre respuestas repetidas
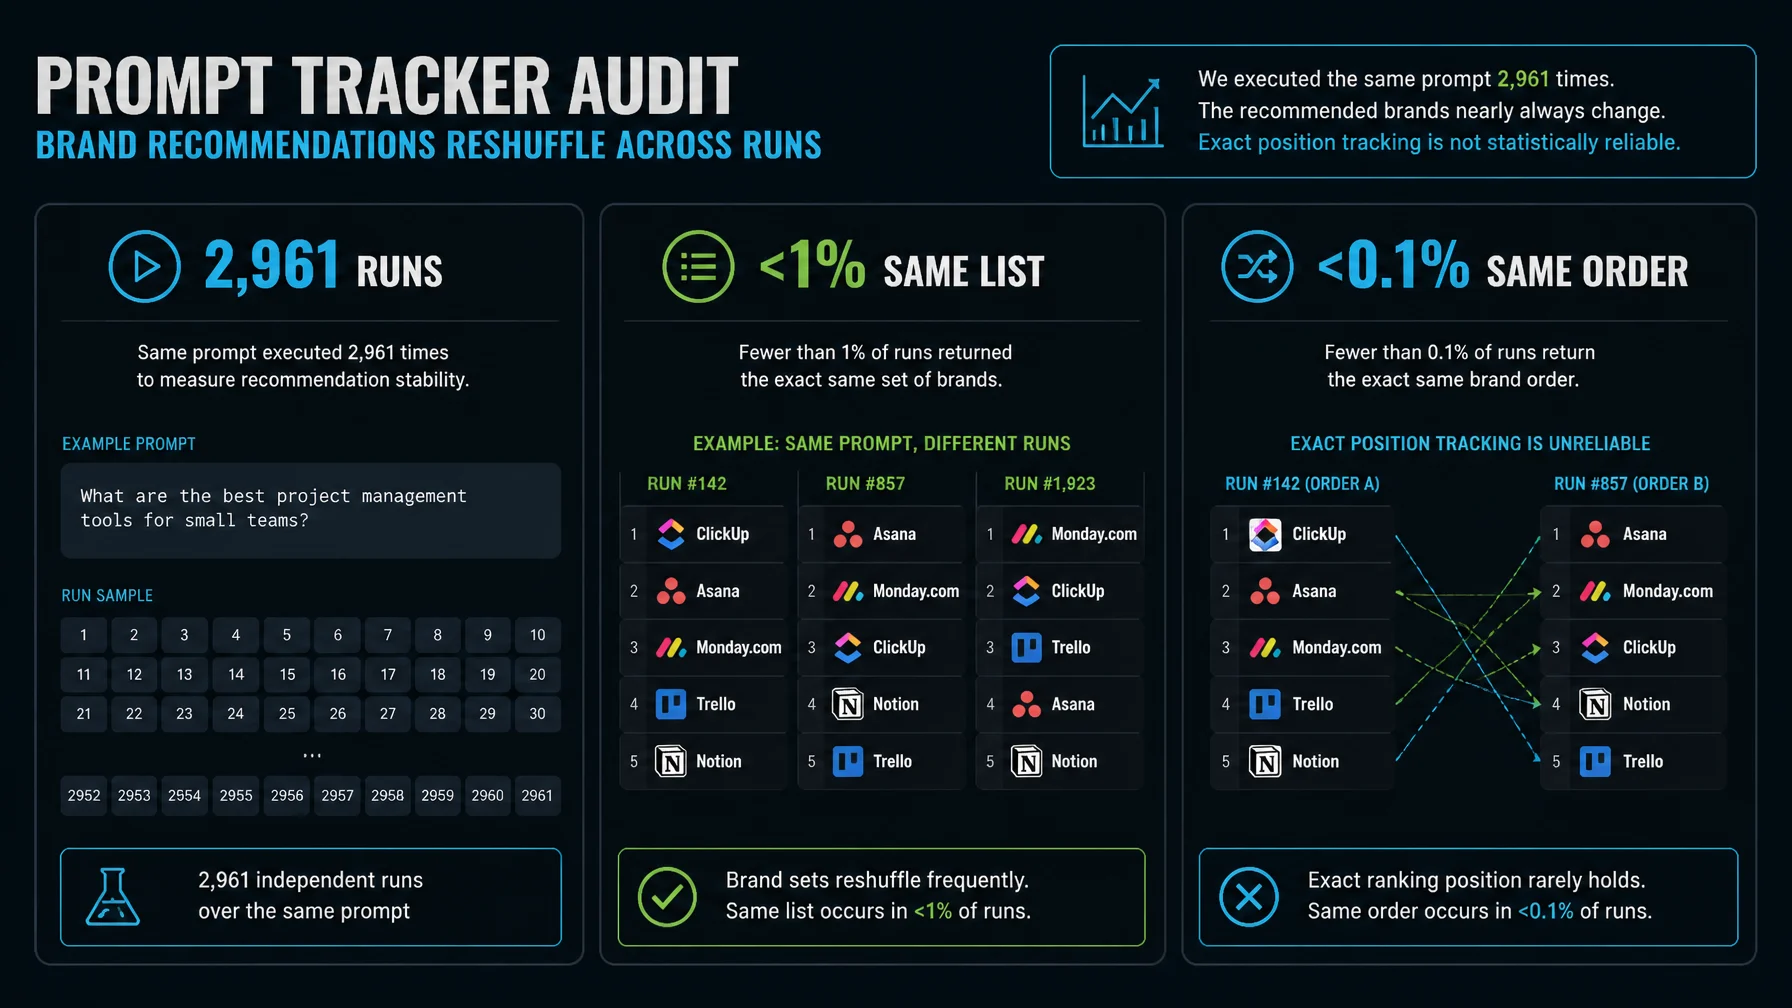
La investigación publicada por SparkToro reunió 2.961 ejecuciones de 12 prompts realizadas por 600 voluntarios en ChatGPT, Claude y Google AI. El estudio encontró muy poca repetición exacta de listas de marcas. Esa prueba pertenece a los prompts y condiciones estudiados, pero ilustra por qué una ejecución aislada no sostiene una conclusión.
La respuesta metodológica consiste en repetir, conservar resultados crudos y publicar dispersión. Un informe puede mostrar el porcentaje de ejecuciones donde apareció la marca, la proporción con cita y las fuentes más frecuentes. Ordenar marcas del primero al décimo como si cada una ocupara una posición fija descarta la variación que el propio experimento produjo.
Diferencias entre API e interfaz
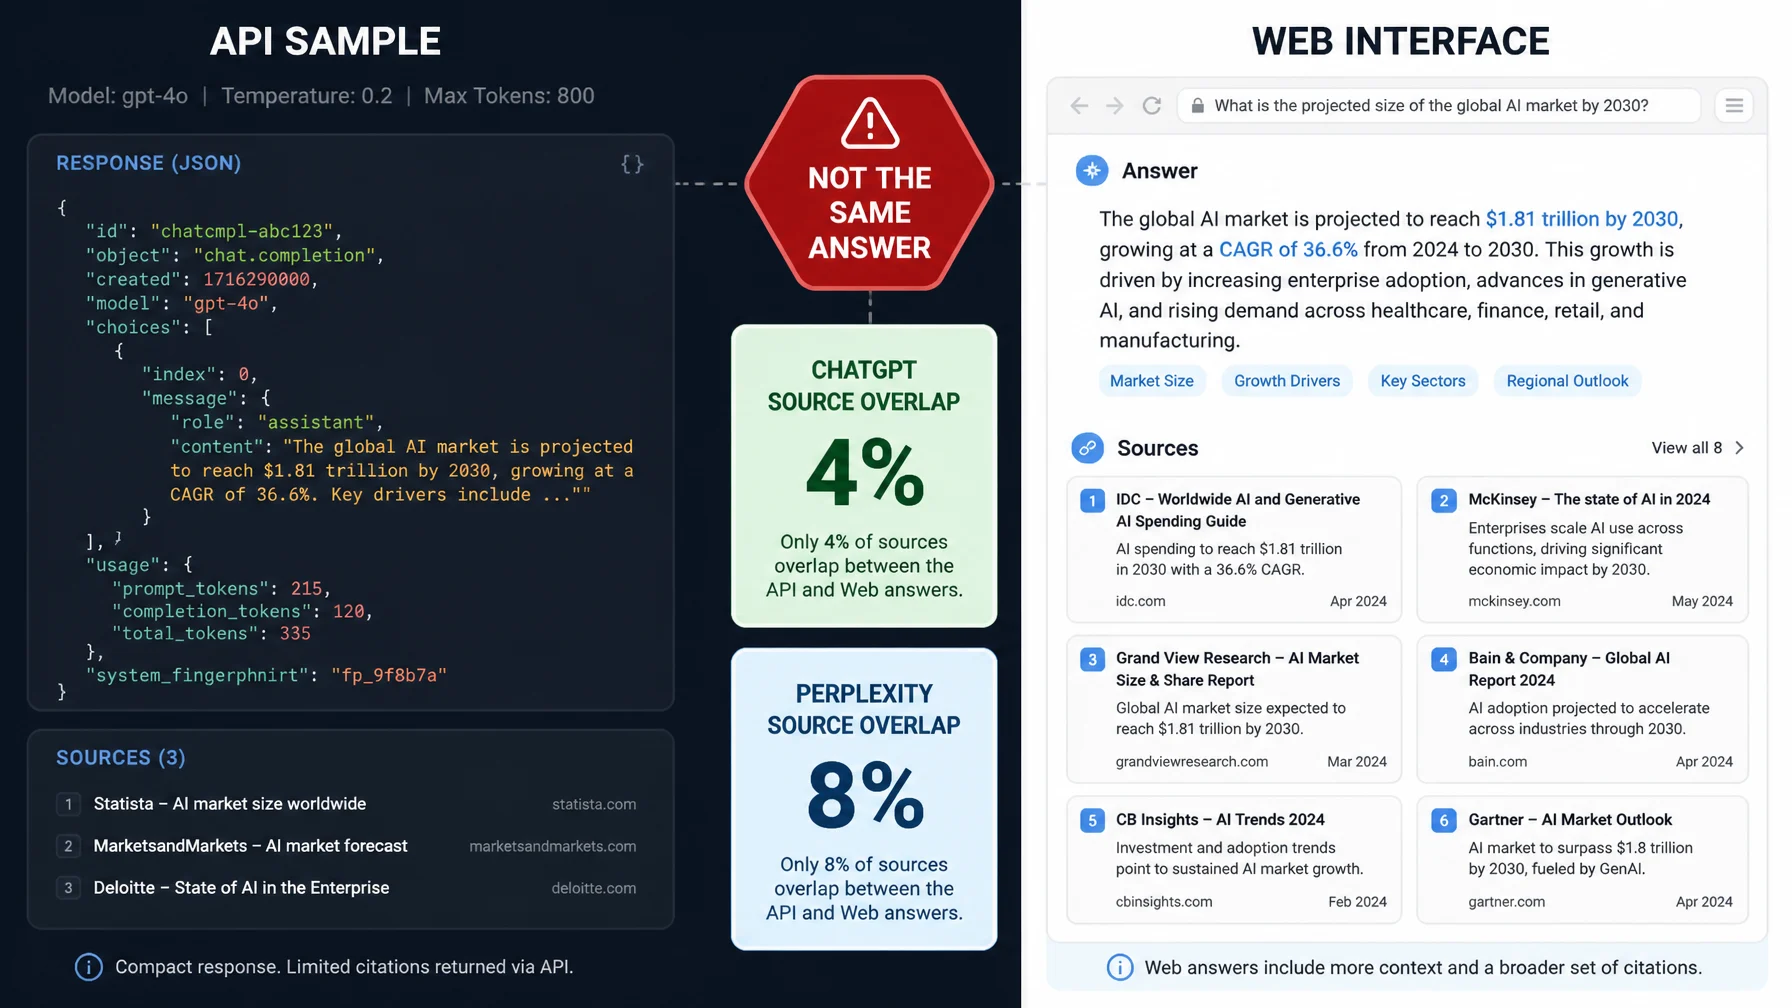
Surfer comparó respuestas de API con interfaces web y reportó diferencias en fuentes y marcas recuperadas. El resultado no convierte el scraping en una representación perfecta. Confirma que elegir una API por conveniencia puede medir otro producto.
Una interfaz puede añadir búsqueda, personalización, memoria o herramientas. La API puede usar otro modelo y parámetros distintos. Por eso cada fila del experimento necesita registrar la superficie consultada. Un nombre genérico como "ChatGPT" no basta.
Muestras controladas de Google AI Mode
DataForSEO documenta endpoints para Google AI Mode y aclara que omite preferencias e historial personal. Esa exclusión mejora la comparabilidad entre ejecuciones, aunque reduce la semejanza con una sesión individual.
SerpApi ofrece otra interfaz de consulta y expone tokens para solicitudes de seguimiento. En ambos casos, el valor está en un procedimiento controlado. El resultado describe la configuración de la prueba, no la distribución completa de respuestas que Google mostró a todos los usuarios.
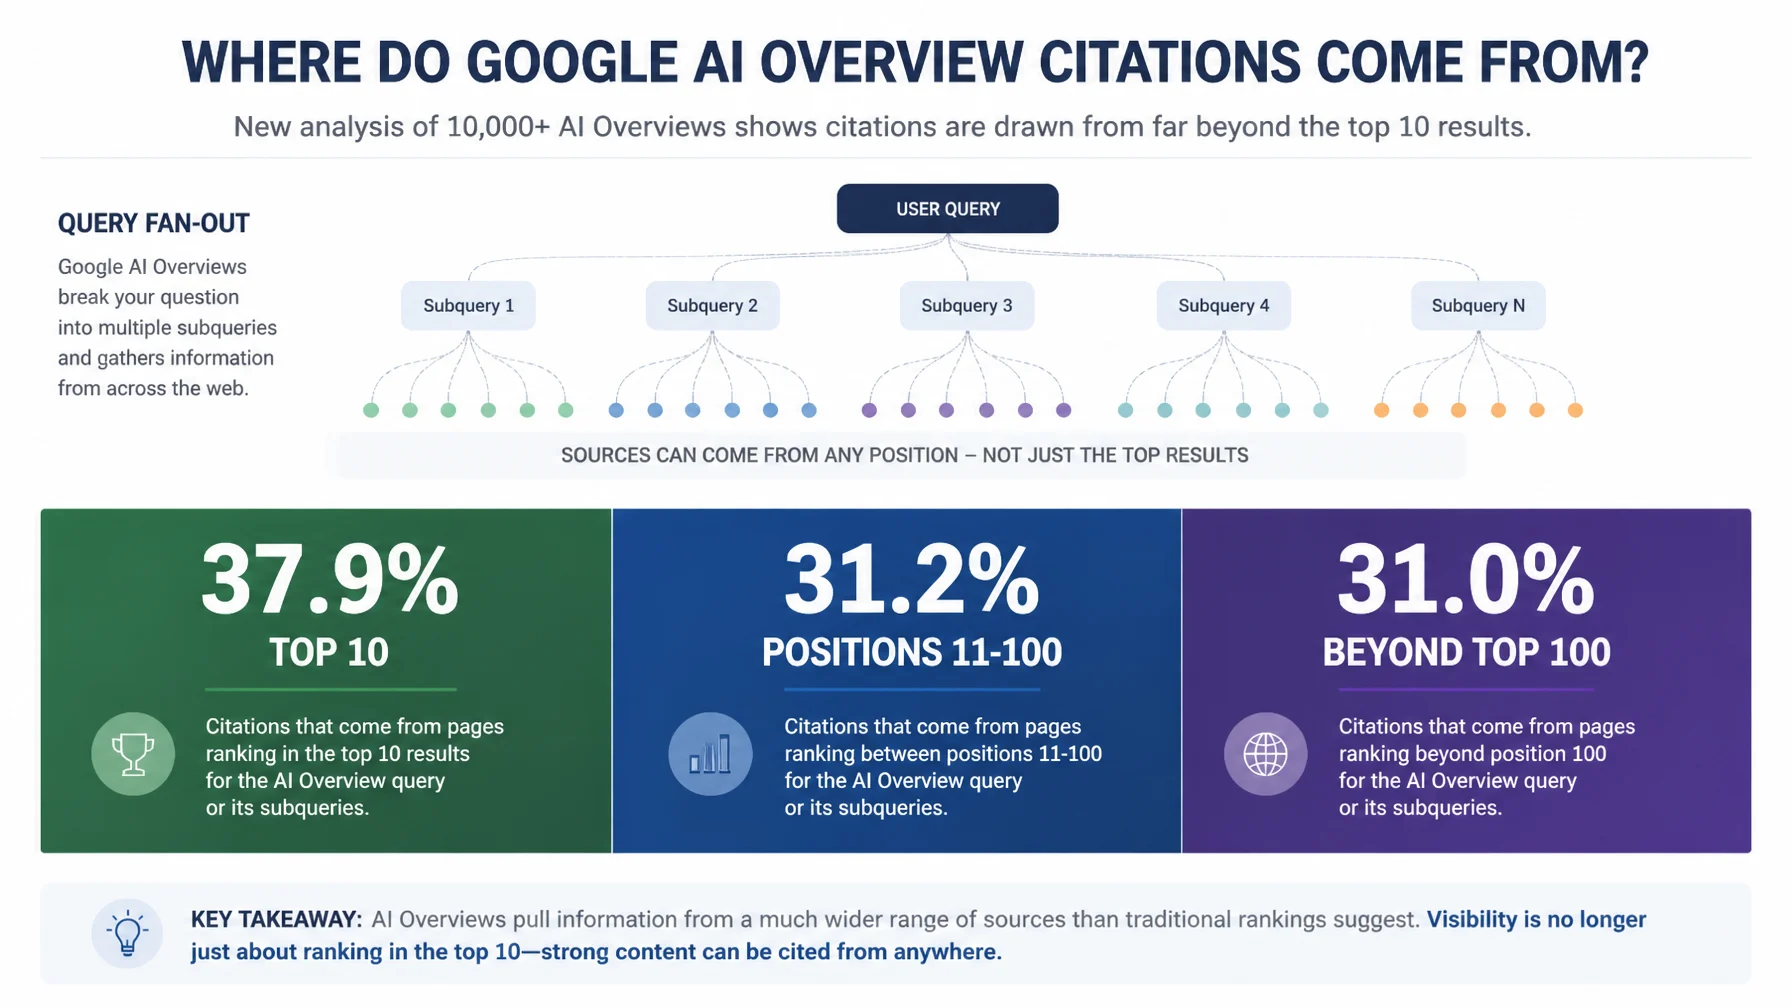
Como referencia, Ahrefs analizó 863.000 SERPs y cuatro millones de URLs citadas. Reportó que el 37,9% de las URLs citadas aparecía en los primeros diez bloques orgánicos de la misma consulta. El resto estaba en posiciones inferiores o fuera de los primeros cien bloques. La muestra respalda una relación parcial entre visibilidad orgánica y citas, no una posición exclusiva de IA.
Criterios para evaluar un proveedor
| Pregunta | Evidencia necesaria | Riesgo si falta |
|---|---|---|
| ¿De dónde salen los prompts? | Fuente, idioma, mercado y método de muestreo. | La puntuación puede reflejar preguntas que nadie usa. |
| ¿Cuántas repeticiones ejecuta? | Conteo por prompt y distribución de resultados. | Una respuesta aleatoria parece estable. |
| ¿Qué superficie consulta? | Modelo, API o interfaz, herramientas y fecha. | Se comparan productos diferentes bajo una sola etiqueta. |
| ¿Cómo cuenta menciones y citas? | Reglas, ejemplos y tratamiento de variantes de marca. | El numerador cambia sin que el usuario lo vea. |
| ¿Entrega datos crudos? | Exportación de respuestas, fuentes y timestamps. | No se puede auditar el score. |
| ¿Mantiene la serie comparable? | Registro de cambios de modelo y metodología. | Una actualización parece mejora o caída de la marca. |
Prioridad de los datos propios
Los logs muestran rastreo y solicitudes. La analítica registra referencias cuando el navegador las conserva. Search Console documenta la visibilidad de búsqueda de Google según las dimensiones disponibles. Las conversiones indican si una visita produjo una acción. Esas capas siguen incompletas, pero pertenecen al sitio y pueden reconciliarse.
Cuando una plataforma ofrece datos para un dominio verificado, guarda su definición exacta. Una consulta de fundamentación, una cita y una impresión no son sinónimos. La metodología de atribución para búsqueda generativa evita sumar eventos diferentes bajo una sola métrica de visibilidad.
Auditoría transparente con DataForSEO o SerpApi
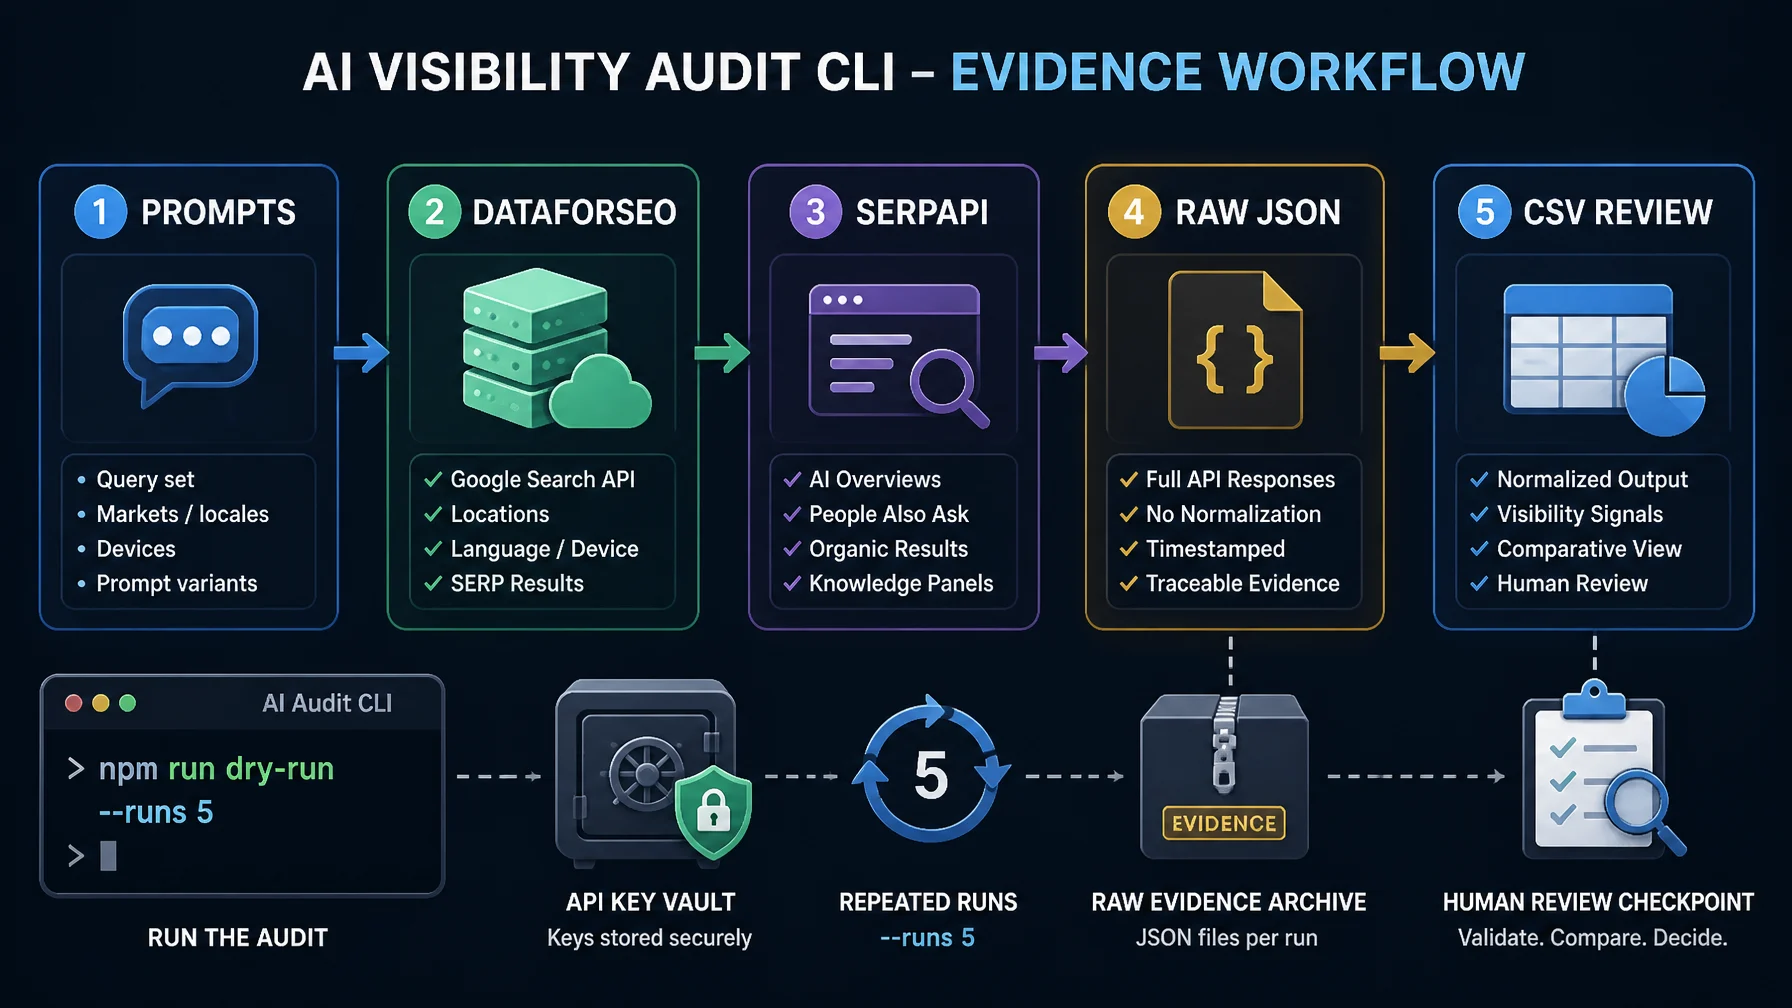
El paquete AI Visibility Audit Lite ejecuta pruebas repetidas y exporta JSON y CSV. La herramienta no estima una audiencia ni predice ventas. Sirve para conservar una muestra que otro analista pueda revisar.
- Define preguntas por etapa de decisión y registra su origen.
- Fija país, idioma, dispositivo y proveedor.
- Ejecuta varias repeticiones en fechas separadas.
- Conserva la respuesta, las URLs citadas y el timestamp.
- Calcula presencia y citas como proporciones, con el denominador visible.
- Compara cambios solo cuando la metodología permanece igual.
- Investiga las páginas fuente antes de proponer contenido nuevo.
Regla de decisión
Usa un tracker para descubrir una pregunta sin cubrir, una fuente recurrente o una variación que merece estudio. Exige datos propios antes de atribuir tráfico, oportunidades o ingresos. Si el proveedor no expone su muestra y sus cambios metodológicos, el score no debería decidir presupuesto.
La guía de Google para búsqueda con IA mantiene las mismas bases de acceso, contenido útil y políticas. Ningún panel externo modifica esos requisitos.
Preguntas frecuentes
¿Un prompt tracker equivale a un rank tracker?
No. El prompt tracker observa una muestra de respuestas variables. Un rank tracker trabaja con una superficie y una posición más definidas.
¿La posición de una marca en una respuesta es una métrica estable?
No suele serlo. Conviene medir la proporción de apariciones y conservar la distribución entre repeticiones.
¿Una API reproduce la experiencia de la interfaz?
No necesariamente. La interfaz puede incorporar búsqueda, contexto, memoria y herramientas que la API no utiliza.
¿Qué dato tiene prioridad para una decisión comercial?
Empieza por conversiones, referencias, logs y datos de plataformas verificadas. Usa la simulación para explicar hipótesis y vacíos.
Sobre el autor