Construí una habilidad técnica de auditor SEO para Claude AI
Una habilidad práctica de Claude para las auditorías técnicas de SEO que convierten HTML, exportaciones de rastreo, datos de GSC y datos de la inspección URL en hallazgos prioritarios del tipo de consultor.

Guía del auditor técnico SEO
La skill y su flujo de validación
El video muestra cómo convertir HTML, exportaciones de rastreo y datos de Search Console en hallazgos con evidencia, prioridad, responsable y una prueba posterior a la corrección.
TL;DR: esta skill obliga a Claude a relacionar cada hallazgo con una evidencia observable, declarar su nivel de confianza y definir cómo se comprobará la corrección. Puedes descargar el archivo SKILL.md y adaptarlo a tu sitio.
El resultado útil de una auditoría técnica es una decisión revisable. Una lista extensa de títulos duplicados, recursos bloqueados o advertencias de schema aporta poco si no distingue la plantilla afectada, la exposición orgánica y la prueba que falta.
Una exportación de crawler suele mezclar defectos con consecuencias muy distintas. Un `alt` ausente, una canonical incoherente y una ruta que responde como 200 aunque no exista pueden aparecer en el mismo archivo. La prioridad cambia cuando se añaden datos de Search Console, una muestra de HTML renderizado y el propósito comercial de las URLs.
La skill organiza esas capas sin adjudicarle a Claude acceso que no tiene. Si el usuario entrega HTML fuente, Claude puede analizar ese archivo. Para afirmar qué aparece después de ejecutar JavaScript necesita DOM renderizado o una herramienta que lo obtenga. Para hablar de indexación necesita evidencia de Search Console, no una inferencia basada en el sitemap.
Contrato de evidencia de la skill
Anthropic define las Agent Skills como recursos reutilizables basados en archivos. Las personalizadas se crean dentro de un directorio con un `SKILL.md`, y Claude las carga cuando la descripción coincide con la tarea. La documentación oficial de Agent Skills también advierte que la disponibilidad de red y el modelo de instalación cambian entre Claude Code, claude.ai y la API.
El archivo descargable de esta página aplica ese formato a auditorías técnicas. Cada hallazgo debe contener estos elementos:
- Estado de la afirmación. Confirmada, hipótesis o evidencia insuficiente.
- Señal observada. Fila del crawl, respuesta HTTP, HTML, informe de Search Console o línea de log.
- Consecuencia posible. Qué parte del rastreo, indexación, medición o conversión puede verse afectada.
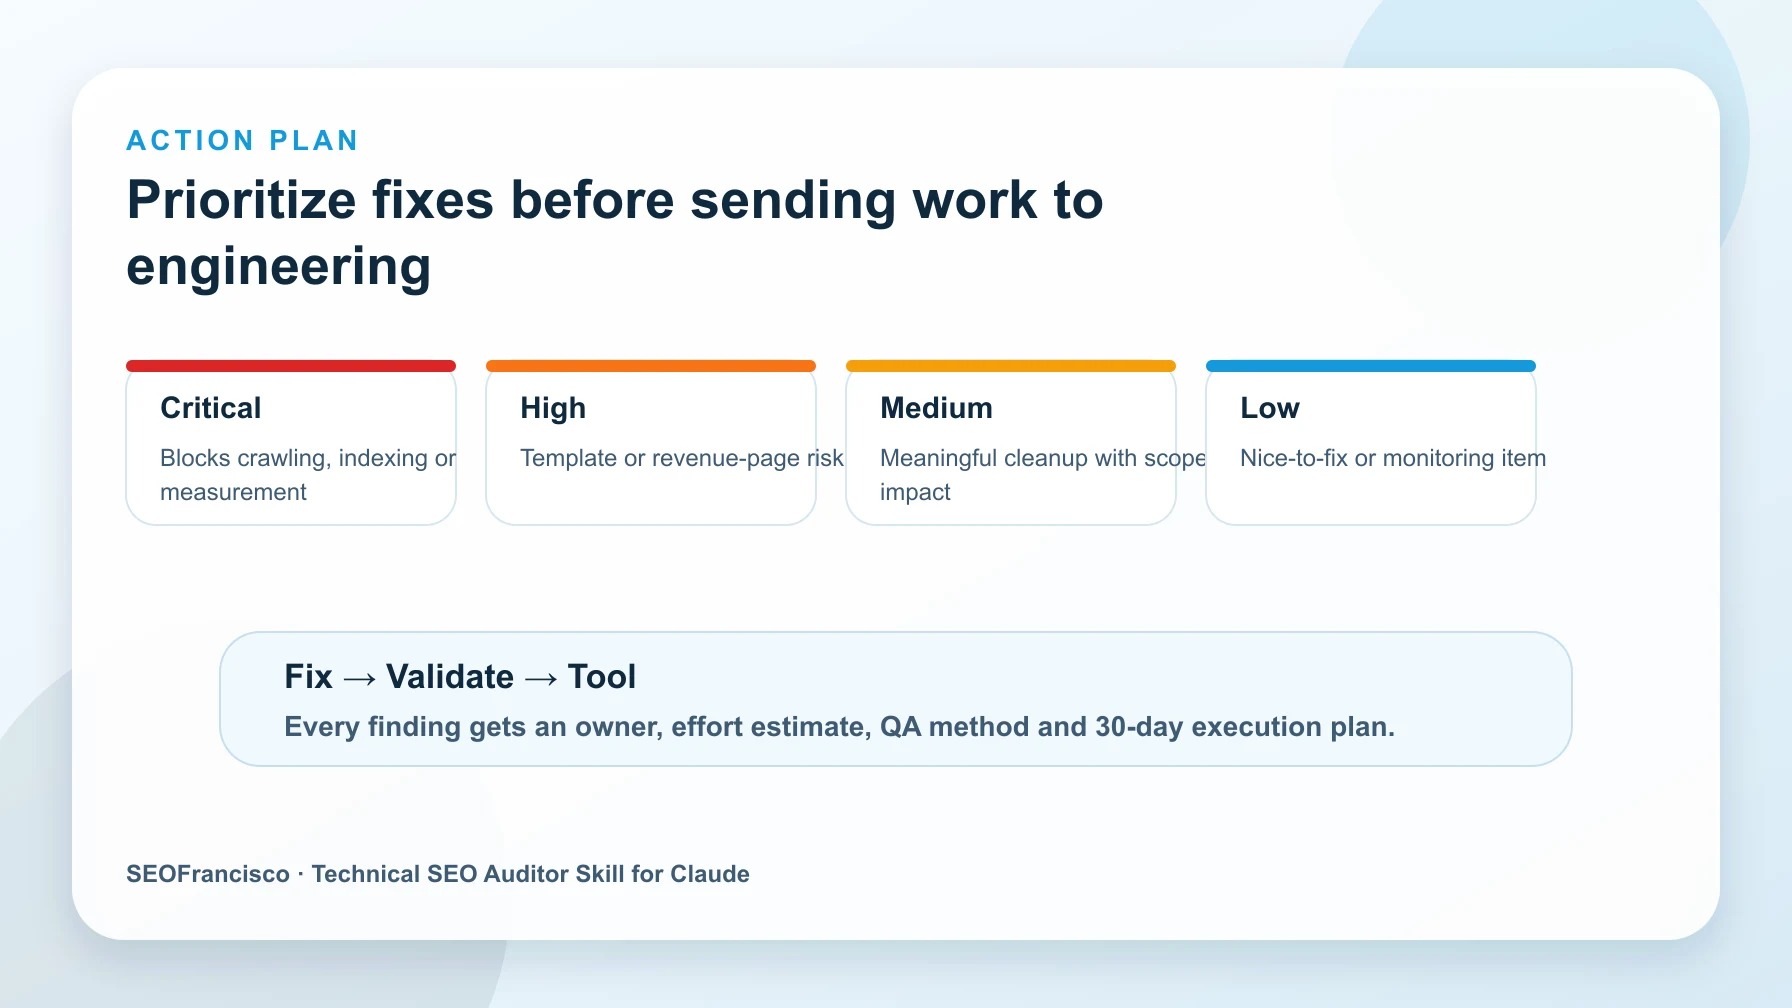
- Prioridad y esfuerzo. Una clasificación que considere alcance y dependencia técnica.
- Responsable y validación. Quién corrige el problema y qué condición debe cumplirse después.
La regla más importante aparece cuando falta una de esas piezas. Claude debe pedir el insumo o rebajar el hallazgo a hipótesis. La guía de autoría de Anthropic recomienda skills concisas, bien estructuradas y probadas con uso real. Por eso el procedimiento define un contrato de salida y deja los datos del sitio fuera de las instrucciones permanentes.
Fuentes de auditoría con funciones distintas
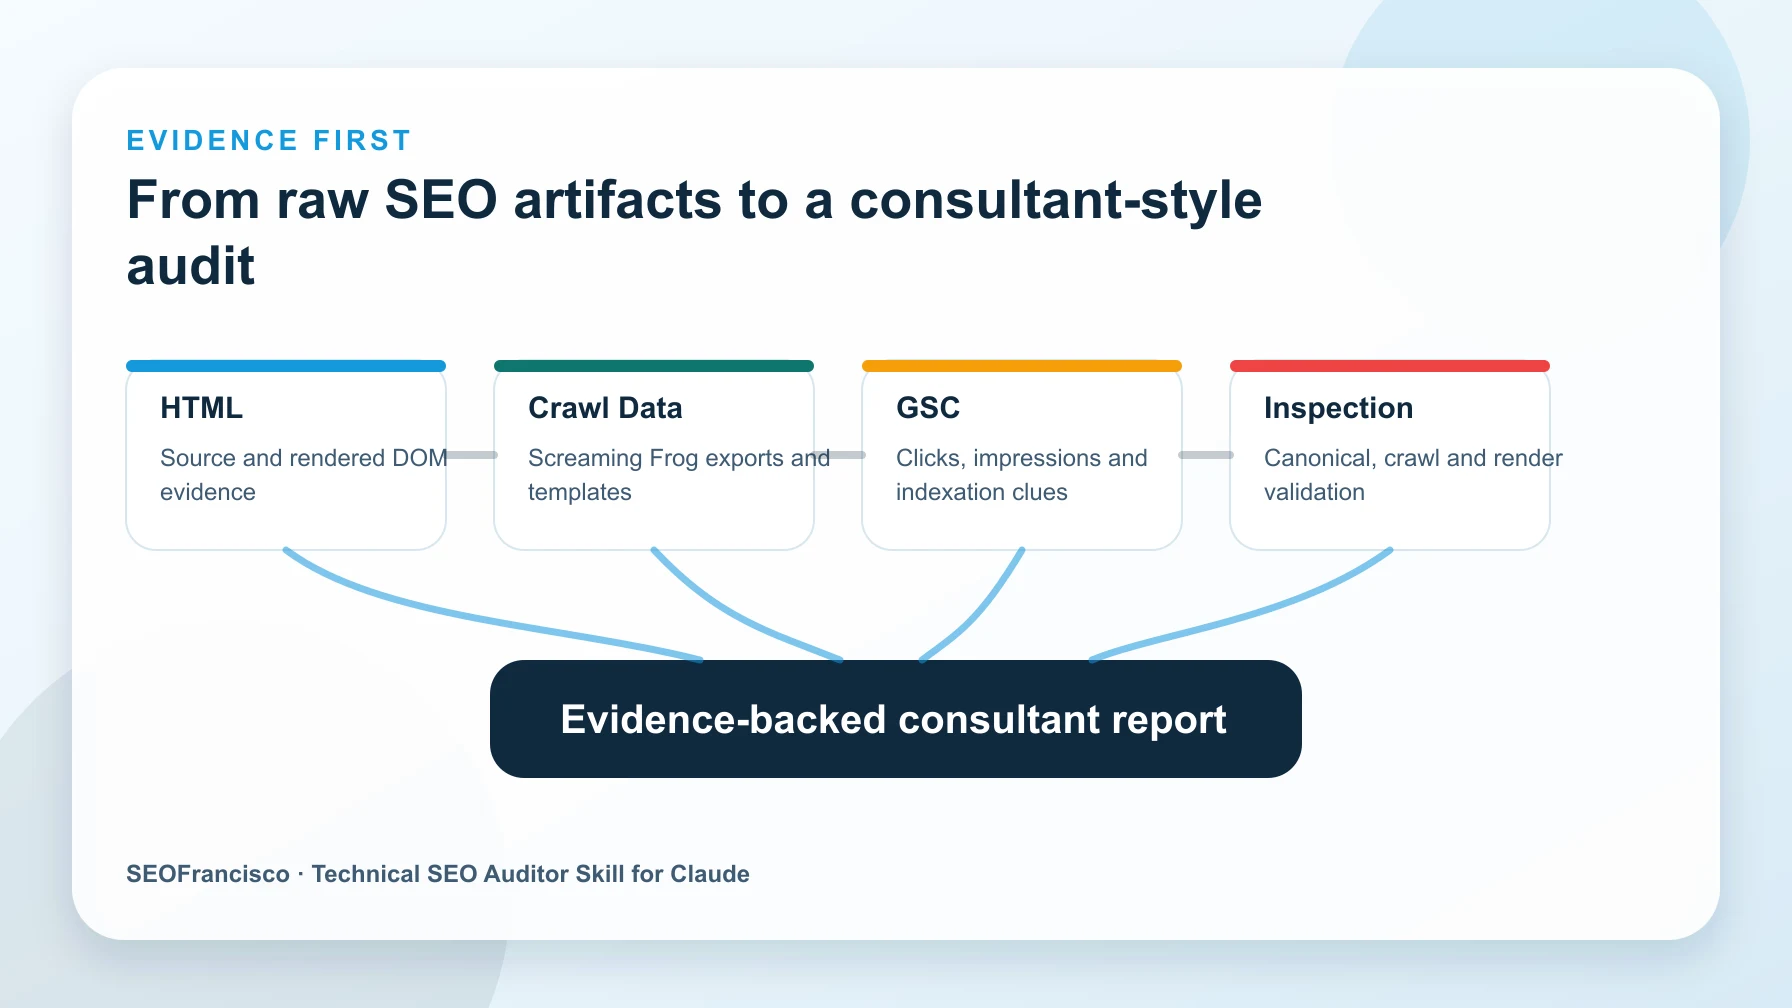
Un crawl describe lo que la herramienta encontró bajo una configuración concreta. Search Console registra lo que Google observó o midió en sus propios sistemas. El navegador permite estudiar el DOM y las peticiones de una sesión. Los logs muestran solicitudes que llegaron al servidor. Ninguna fuente sustituye a las demás.
| Fuente | Decisión que ayuda a tomar | Límite principal |
|---|---|---|
| HTML fuente y cabeceras | Estado HTTP, directivas, canonical y contenido entregado por el servidor | No demuestra el DOM final cuando JavaScript cambia la página |
| HTML renderizado | Paridad de contenido, enlaces, metadatos y datos estructurados | Una muestra no demuestra que toda la plantilla tenga el mismo resultado |
| Exportación de crawler | Alcance, patrones y defectos repetidos | Depende de configuración, permisos y cobertura |
| Search Console | Rendimiento, señales de indexación y estado observado por Google | Los informes tienen retrasos, agregación y límites de muestra |
| Logs y analítica | Solicitudes reales, errores, atribución y conversiones | Requiere una implementación fiable y un periodo definido |
La Inspección de URLs de Search Console ilustra bien esta separación. El informe de la URL indexada refleja la versión que Google conoce. La prueba publicada comprueba accesibilidad e indexabilidad potencial en ese momento, pero un resultado válido no garantiza la inclusión en el índice. La canonical seleccionada por Google solo se consulta en los datos indexados.
Diez áreas bajo un mismo criterio
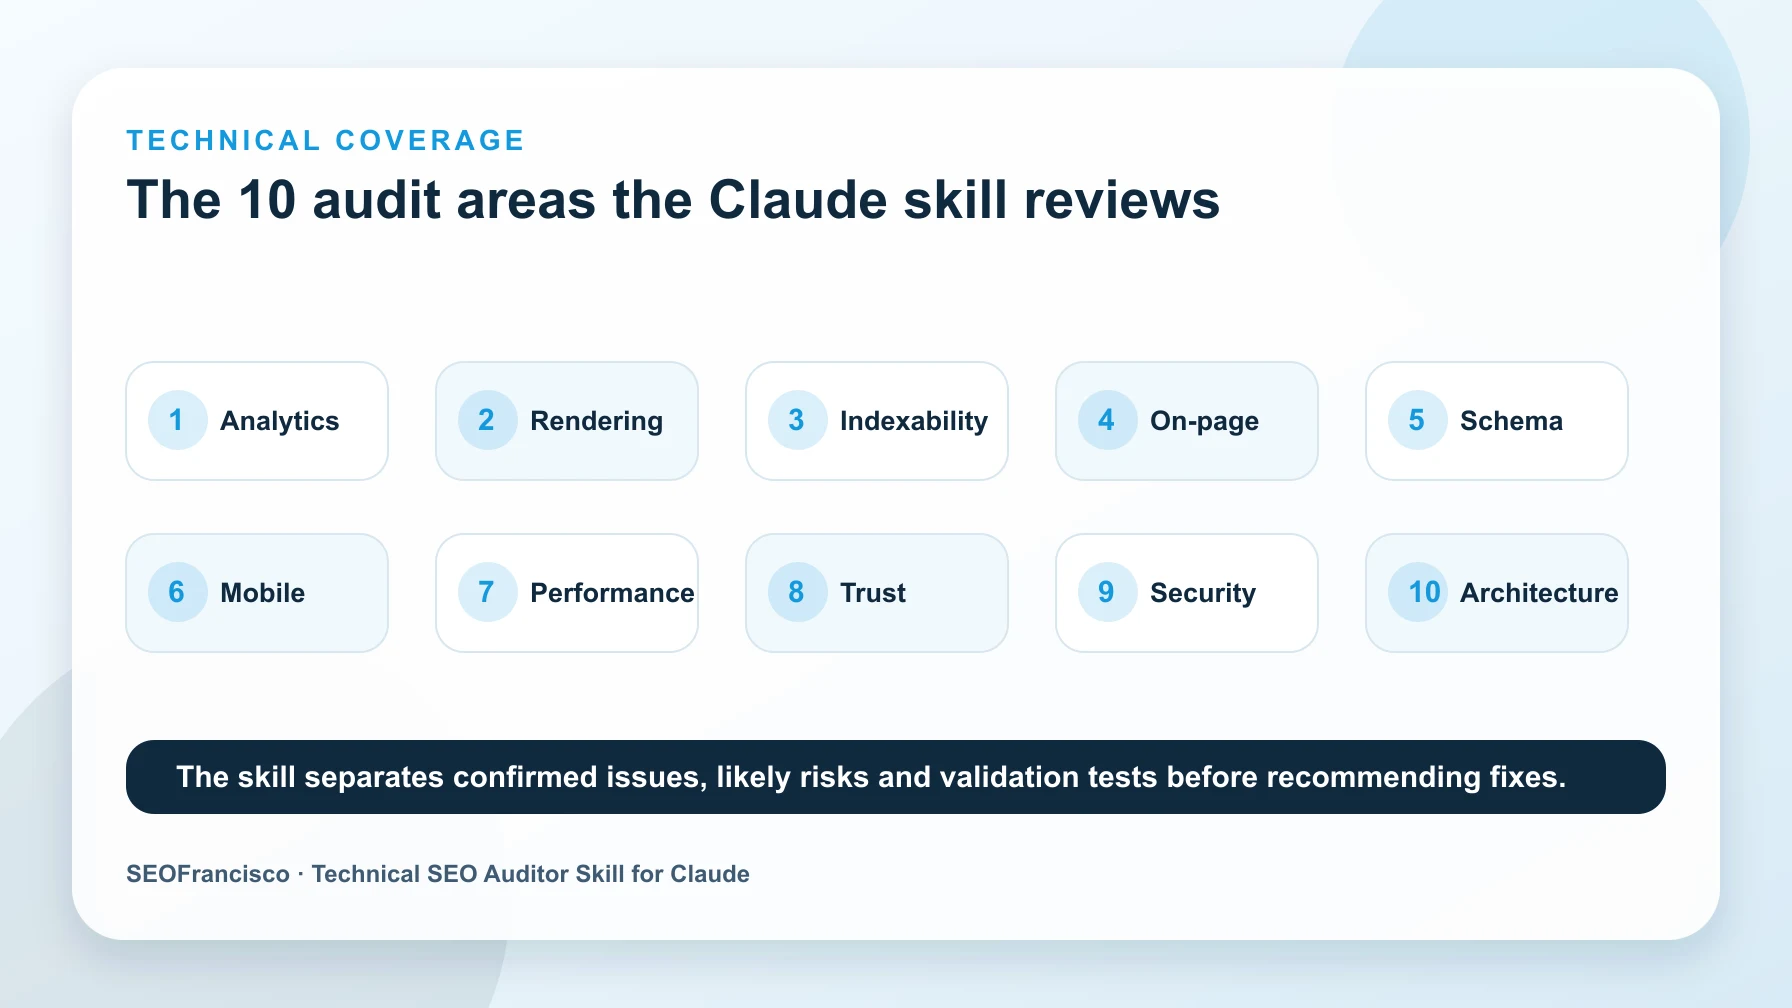
El marco divide la revisión en diez áreas para evitar huecos de cobertura. Esa división pertenece a la skill, no a una lista oficial de factores de ranking. Cada área se examina únicamente cuando existe una fuente adecuada.
- Analítica y seguimiento. Etiquetas duplicadas, consentimiento, eventos y atribución.
- Renderizado y JavaScript. Diferencias entre respuesta inicial y DOM final.
- Rastreabilidad e indexabilidad. Estados, redirects, robots, canonical, noindex y sitemaps.
- SEO técnico on-page. Títulos, encabezados, enlaces, imágenes y defectos de plantilla.
- Datos estructurados. Sintaxis, propiedades, duplicados y correspondencia con contenido visible.
- Vista móvil. Paridad, navegación, solapamientos y estabilidad visual.
- Rendimiento. Datos de campo, pruebas de laboratorio y recursos costosos.
- Confianza y calidad. Autoría, políticas, fuentes, actualidad y propósito de la página.
- Seguridad y base técnica. HTTPS, contenido mixto, errores de servidor y entornos expuestos.
- Arquitectura internacional. hreflang, clusters regionales, profundidad y rutas internas.
La lista evita que un problema visible absorba toda la auditoría. También impide convertir cada advertencia en ticket. Si un informe de laboratorio señala un recurso pesado, la recomendación debe explicar la plantilla afectada, la métrica relacionada y el dato que permitirá validar una mejora.
Renderizado, enlaces y estados HTTP
Google procesa las aplicaciones JavaScript mediante rastreo, renderizado e indexación. Su guía de SEO para JavaScript explica que Googlebot vuelve a extraer enlaces del HTML renderizado y usa ese resultado para indexar. También recomienda respuestas HTTP significativas y advierte sobre los 404 suaves en aplicaciones que devuelven 200 para rutas inexistentes.
La auditoría compara tres estados cuando JavaScript interviene:
- La respuesta del servidor, incluida la URL final, el código HTTP y las cabeceras.
- El HTML inicial, con su title, canonical, robots, enlaces y contenido principal.
- El DOM renderizado después de que carguen scripts y datos necesarios.
Una diferencia no implica automáticamente un error. El hallazgo aparece cuando la variación elimina o contradice una señal necesaria. Una canonical que cambia hacia otra URL, un enlace que requiere una interacción o una ruta vacía con estado 200 necesitan pruebas distintas y correcciones diferentes.
Directivas, canonical y selección de URL
`robots.txt` regula el rastreo, mientras que `noindex` comunica una instrucción de indexación mediante metaetiqueta o cabecera HTTP. Google documenta ambas variantes en sus especificaciones de robots. Una página bloqueada por `robots.txt` puede impedir que el rastreador vea su `noindex`, de modo que las dos capas deben revisarse juntas.
La canonical requiere otra lectura. Google la trata como una señal para elegir la URL representativa entre páginas duplicadas o muy parecidas. La documentación de canonicalización recomienda señales coherentes y URLs internas que apunten a la versión preferida. Una etiqueta correcta en una sola muestra no resuelve enlaces, redirects o sitemaps contradictorios.
La skill comprueba primero si Google puede solicitar la URL y después verifica si la página permite indexación. Al final compara la canonical declarada, la seleccionada por Google y las señales internas del cluster. Ese orden evita atribuir a una etiqueta canonical un problema que empezó en el servidor o en la arquitectura.
Datos estructurados y rendimiento medible
Un bloque JSON-LD válido puede seguir siendo inadecuado si describe información que la página no muestra. La introducción oficial a los datos estructurados pide representar el contenido visible y usar el tipo específico de la función correspondiente. El Rich Results Test comprueba la implementación renderizada, pero la elegibilidad técnica no promete que Google muestre un resultado enriquecido.
El rendimiento necesita la misma disciplina. Las Métricas web principales se evalúan con datos de uso reales, mientras que Lighthouse y PageSpeed ofrecen diagnóstico de laboratorio. Google presenta LCP, INP y CLS dentro de sus conceptos básicos de Core Web Vitals y recomienda alcanzar buenos valores sin convertirlos en el único criterio de relevancia.
Una recomendación de rendimiento debe nombrar la evidencia disponible. Si solo existe una ejecución de Lighthouse, la conclusión se limita al entorno probado. Los datos de campo permiten observar usuarios reales, aunque tampoco identifican por sí solos el recurso que causa el problema. La combinación sirve para pasar de síntoma a cambio verificable.
Formato de hallazgo para una decisión técnica
El formato obliga a mostrar el razonamiento que suele quedar oculto dentro de un informe largo.
Hallazgo
La plantilla de categoría declara una canonical con un parámetro que no corresponde a la URL limpia.

Estado
Confirmado en la muestra revisada. Falta medir el alcance total.

Evidencia
- Exportación de canonicals con URL fuente y destino.
- HTML renderizado de una página representativa.
- Impresiones registradas para la carpeta afectada.

Impacto
La plantilla envía una señal contradictoria sobre la URL que debe representar el contenido.

Corrección
Generar la canonical limpia desde la plantilla y revisar las excepciones intencionales.

Responsable
Ingeniería con QA de SEO.

Validación
Volver a rastrear la plantilla, comparar HTML y revisar una muestra en Inspección de URLs.
El ejemplo no afirma que todas las páginas compartan el defecto. El alcance se calcula con un nuevo crawl o una consulta reproducible. Tampoco promete recuperación de rankings, ya que la corrección elimina una contradicción técnica sin aislar el resto de variables.
Flujo de trabajo para una auditoría reproducible
- Definir la pregunta. Por ejemplo, investigar por qué una familia de productos aparece como descubierta y no indexada.
- Elegir una muestra. Incluir URLs afectadas, controles sanos y las plantillas relacionadas.
- Reunir evidencia. Exportar solo las columnas necesarias y registrar fecha, configuración y cobertura.
- Ejecutar la skill. Pedir hallazgos confirmados, hipótesis y pruebas pendientes en campos separados.
- Revisar el criterio. Un SEO valida el propósito de la URL, el impacto comercial y las dependencias del CMS.
- Corregir y volver a medir. Repetir las pruebas con las mismas condiciones y conservar el resultado.
El tamaño del archivo no mejora la auditoría por sí mismo. Un extracto pequeño que responde a una pregunta concreta suele permitir una revisión más precisa que un dump con columnas irrelevantes. Los casos que afectan varias plantillas pueden ampliarse después de confirmar el patrón.
Límites de automatización y revisión humana
La skill no sustituye al crawler, Search Console, el navegador ni los logs. Tampoco concede acceso automático a esas fuentes. Claude trabaja con los archivos y herramientas disponibles en la superficie donde se ejecuta. La documentación de Anthropic señala, por ejemplo, que las skills de la API funcionan en un contenedor sin red, mientras Claude Code hereda el acceso de la computadora del usuario.
La revisión humana sigue siendo necesaria cuando la solución depende del propósito de la página, el modelo comercial o una decisión legal. Un `noindex` puede ser correcto para una búsqueda interna y desastroso para una colección que genera ventas. Un schema válido puede describir una oferta que el usuario no ve. La automatización encuentra la contradicción y organiza la evidencia. El responsable del sitio acepta o rechaza el cambio.
Descarga y prueba controlada
Descarga la skill de auditor técnico SEO para Claude y pruébala primero sobre una sola pregunta. Conserva los archivos de entrada, el informe y la validación posterior. Esa comparación permite ajustar prioridades y eliminar instrucciones que no aportan una decisión.
Para una revisión más amplia, la asesoría técnica SEO conecta crawl, renderizado, Search Console y QA de despliegue dentro del mismo plan. La skill puede acelerar el análisis, mientras el alcance y la aceptación final permanecen visibles para el equipo.
Preguntas sobre la skill
¿La skill rastrea un sitio por su cuenta?
Solo puede rastrear si la sesión dispone de una herramienta autorizada para hacerlo. Sin esa herramienta, analiza los archivos, URLs y exportaciones entregados y debe declarar el límite.
¿Puede reemplazar Screaming Frog o Search Console?
La skill interpreta evidencia y organiza decisiones. El crawler obtiene patrones técnicos y Search Console aporta datos observados por Google. Ambos siguen siendo fuentes necesarias cuando la pregunta depende de ellos.
¿Qué datos conviene preparar para la primera prueba?
Empieza con una pregunta, una muestra de URLs, HTML fuente y renderizado cuando corresponda, las columnas relevantes del crawl y la evidencia disponible de Search Console. Registra fecha y configuración.
¿Un hallazgo técnico demuestra una pérdida de rankings?
Un defecto puede justificar una corrección sin probar cuánto tráfico causó. Para atribuir una caída se necesita una línea temporal, páginas afectadas, consultas, cambios coincidentes y controles comparables.
Sobre el autor