
Envenenamiento de recuperación en búsqueda con IA: riesgos, señales y controles verificables
Cómo una fuente web incorrecta puede contaminar una respuesta generada y qué puede hacer un equipo SEO para medir el riesgo sin afirmar mecanismos secretos.
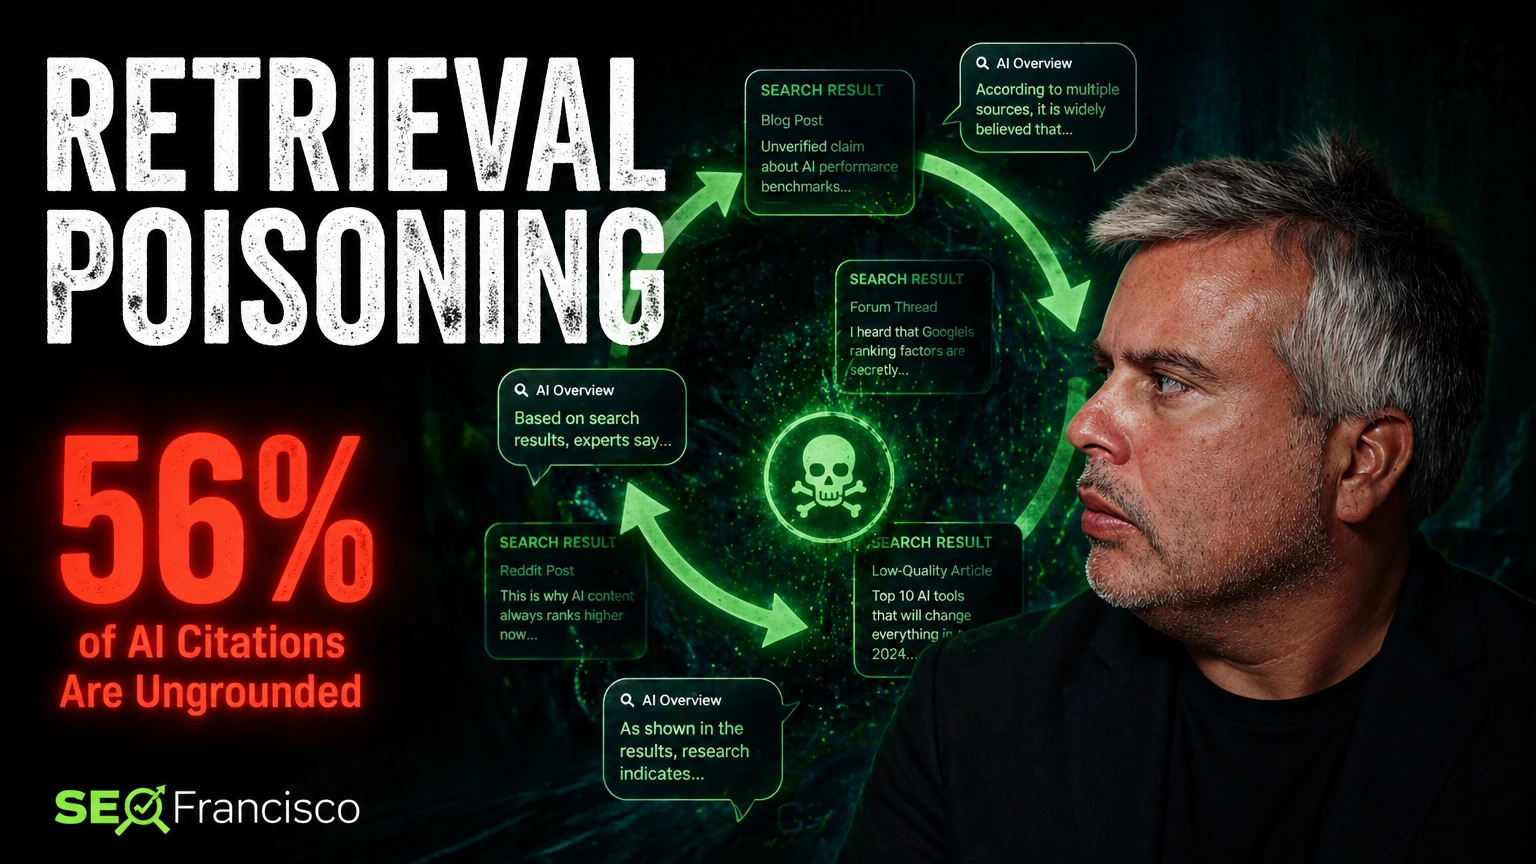
Un sistema con recuperación puede consultar páginas recientes y usarlas como contexto para generar una respuesta. Esa capacidad reduce la dependencia de datos de entrenamiento antiguos, pero abre otra superficie de riesgo: una página falsa, manipulada o desactualizada puede entrar en el conjunto recuperado.
«Envenenamiento de recuperación» describe ese problema. No significa que cada error provenga de un ataque ni que una sola página pueda alterar permanentemente un modelo. Puede tratarse de contenido engañoso deliberado, una afirmación sin fuente, una copia que perdió contexto o un documento que dejó de ser vigente.
La cadena que debe auditarse
Publicación
¿Quién creó la información? ¿Muestra fecha, autor, método y fuente primaria? Una página con muchas citas no es fiable si ninguna respalda la afirmación central.
Acceso y recuperación
Los rastreadores deben poder solicitar la URL, pero acceso no equivale a selección. OpenAI publica los agentes de usuario que utiliza y Google explica que sus funciones de IA pueden realizar búsquedas relacionadas para reunir páginas de apoyo. Ninguna de esas páginas documenta una fórmula pública para escoger cada fuente.
Respuesta y cita
La respuesta puede mencionar un hecho y mostrar uno o varios enlaces. La auditoría debe comprobar si el texto del enlace realmente sostiene el hecho, no limitarse a contar citas.
Método de verificación
Para una muestra de preguntas, guardo la respuesta completa, la fecha y las URLs citadas. Después convierto cada afirmación verificable en una fila:
| Campo | Qué registrar |
|---|---|
| Afirmación | Texto exacto que se evaluará |
| Fuente citada | URL y fecha de acceso |
| Pasaje de apoyo | Fragmento o sección que sostiene la afirmación |
| Resultado | Sostenida, parcial, contradictoria o sin apoyo |
| Fuente primaria | Documento que permite resolver la duda |
| Acción | Corregir, contextualizar, retirar o volver a probar |
No asigno porcentajes generales a partir de una muestra pequeña. Si se publica una tasa de error, debe incluir universo, selección de preguntas, fecha, modelo, criterios y datos que permitan repetir el cálculo.
Qué puede hacer un editor
La defensa más útil es fortalecer la procedencia del propio contenido. En cada página importante:
- enlaza el documento original;
- identifica al autor y al responsable de revisión;
- indica cuándo se verificó la información;
- separa observación, interpretación e hipótesis;
- corrige o retira cifras que no puedan reproducirse;
- evita copiar resúmenes que ya están separados de su contexto.
También conviene monitorizar menciones incorrectas de la marca y mantener un registro de correcciones. Publicar una página para contradecir cada error puede aumentar el ruido. Prioriza afirmaciones que afectan seguridad, dinero, reputación o decisiones del usuario.
Qué no demuestra un clic
Los clics y la interacción pueden formar parte de sistemas agregados, pero no es correcto afirmar que un clic individual mueve directamente una posición. Google publica una guía de sus sistemas de ranking y recuerda que funcionan con muchas señales. Los documentos o testimonios sobre componentes internos deben leerse en su contexto y no convertirse en una receta manipulable.
Para SEO, la decisión práctica no cambia: una página debe satisfacer la consulta, ser accesible y aportar evidencia. Intentar provocar señales de interacción o inundar la web con afirmaciones repetidas añade riesgo de spam y de contaminación, no autoridad.
Fuentes primarias
- Google: funciones de IA y tu sitio web
- Google: guía de sistemas de ranking
- Google: políticas de spam para la búsqueda web
- OpenAI: rastreadores y agentes de usuario
- NIST: marco de gestión de riesgos de IA